文章目录
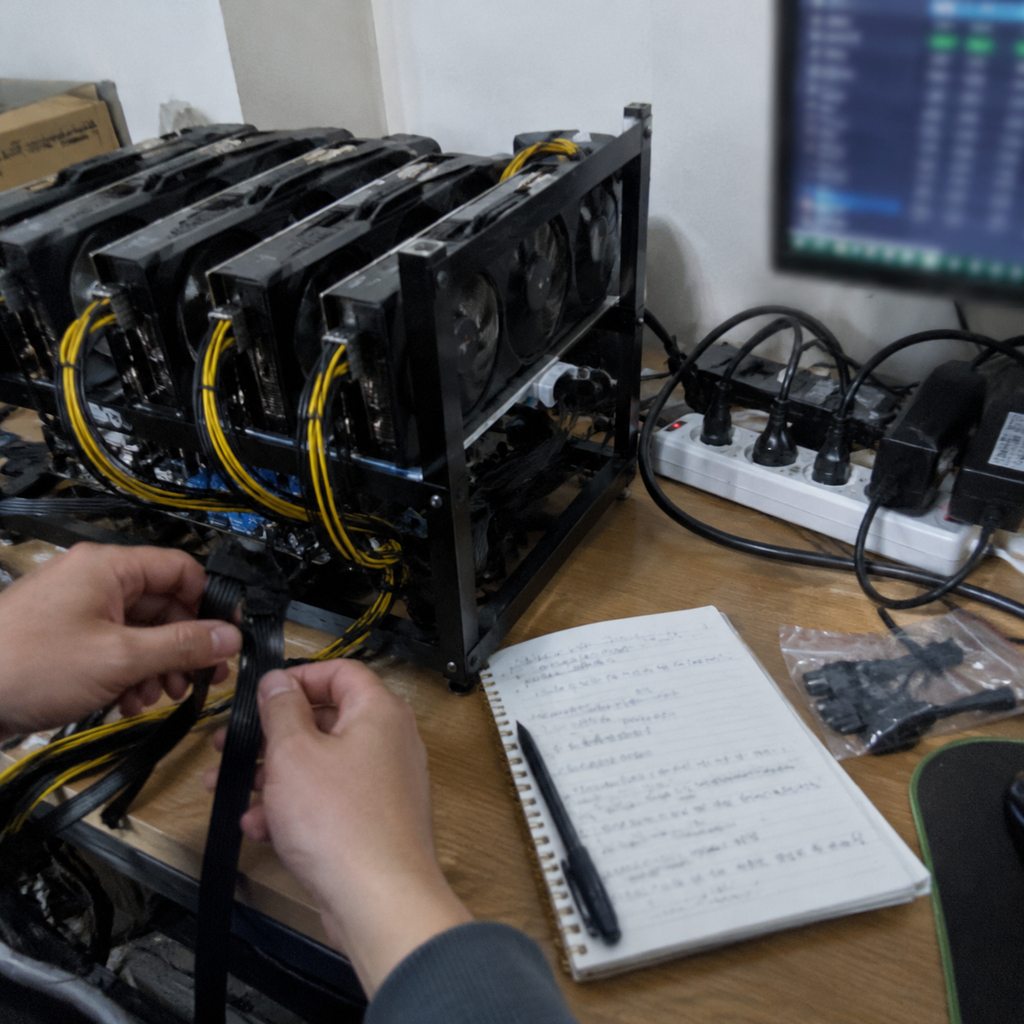
PRL 的超频思路和以太坊时代的显卡挖矿几乎相反。当年 ETC、ETH 那一代拼的是显存带宽,所以"显存 +1000、核心 -500"是标准答案;PRL 走的是矩阵乘法计算,吃的是张量核心吞吐,显存频率拉高基本没用,核心与功耗反而成了关键变量。
这篇文章按"先看量级、再调参数、最后验证"的顺序写,适合已经跑通第一台机器、准备优化每瓦产出的矿工。还没跑通的先看珍珠币 PRL 新手挖矿教程。
先看算力量级,别被单位骗了
PRL 的算力显示单位是 Th/s 量级的矩阵吞吐,和传统显卡币的 MH/s 不是一个量级,也不同源。所以你在别处看到"RTX 3080 82"这种数字时,要先确认单位是 Th/s,否则会得出完全错误的结论。
下面是社区和矿池面板口径的大致量级(截至 2026 年 9 月,属示意性数据,实际会因为驱动、内核版本、散热与供电条件明显浮动):
- RTX 3060 Ti:约 48 Th/s,功耗约 240 W
- RTX 3080:约 82 Th/s,功耗约 340 W
- RTX 4080:约 134 Th/s,功耗约 320 W
- RTX 5070 Ti:约 144 Th/s,功耗约 250 W
- RTX 5080:约 183 Th/s,功耗约 360 W
- RTX 4090:约 230 Th/s,功耗约 450 W
- RTX 5090:约 305–320 Th/s,功耗约 575 W
- 数据中心卡(H100 / B200 一类):600–775 Th/s 量级,但不是家用矿场的选择
看这张表时注意两点。第一,**算力功耗比**比绝对算力更重要,电费是按瓦数付的;第二,这些数字来自矿池上报,不是实验室实测,仅作起点参考,**不要拿它当买卡的决策依据**。
另外要清楚:PRL 只支持 NVIDIA。AMD 与 Intel 显卡目前无法参与 PRL 挖矿,社区矿工软件基本都不支持。买卡之前先确认这一点,能省一大笔冤枉钱。
调参的正确顺序
新手调 PRL 最常犯的错误是一次改三个参数,然后发现算力没变、稳定性变差,却不知道是哪一项造成的。正确顺序是一次只动一个变量:
第一步:先定功耗墙
功耗墙决定了整卡的输出上限,也直接决定电费。建议先用厂商默认功耗的 80% 左右作为起点跑一天,记录算力和实际到账,再往上加。
对 PRL 来说,把功耗从 100% 压到 80% 常常只损失很少的算力,却明显降低电费和温度。这是性价比最高的一步,应该最先做。
第二步:降压而不是拉核心
把核心电压曲线压低,让核心在更低电压下跑到相同频率,能同时改善温度和每瓦产出。这比单纯把核心频率拉高更划算——后者带来的算力增幅通常很小,功耗却涨得明显。
40 系和 50 系显卡在降压上的可调空间比 30 系大,收益也更明显。30 系建议保守一些,先小幅降压观察稳定性。
第三步:显存频率保持默认
这一点和以太坊时代完全不同。PRL 的瓶颈不在显存带宽,拉显存频率几乎不涨算力,反而更容易引入错误、增加被拒份额。
除非你明确知道自己在做什么,否则显存频率就留在默认值。这一步"不动"本身就是最优解。
第四步:观察温度和降频
长时间满负载是挖矿的常态,散热不够会导致显卡自动降频,表现出来就是"刚开机算力正常,跑两小时掉一截"。
判断方法很直接:连续记录开机后 10 分钟、1 小时、6 小时的算力。如果明显下滑,先换热管理再谈参数。
怎么验证调参真的有效
不要只看矿工本地显示的算力。本地算力只反映显卡在算,不反映矿池收到了多少。
有效的验证方式是同一台机器、同一个池,跑满 24 小时后比较**实际到账的 PRL 数量**:
- 换参数前记录一天的实际到账
- 改一个参数,再跑一天
- 只有实际到账提高,才算这次调整有效
如果本地算力涨了但到账没涨,很可能是份额被拒比例升高,问题在提交率而不在参数。这种情况要看PRL 挖矿常见报错排查。
省电的几个实际做法
除了显卡本身的参数,整机层面的省电空间也不小:
- 关掉不必要的外设和主板灯效,减少几瓦到几十瓦的常态消耗
- 电源按实际功耗选,长期低负载运行在效率曲线上并不划算
- 室温每降 1 度,显卡风扇转速和整机功耗都会跟着降
- 多卡机器注意机箱风道,混风会让显卡互相加热
这些看起来都是小事,但按年算下来对电费的影响不小,而 PRL 的利润本来就薄。
一台机器调完,再复制到第二台
调参最忌讳一次全场下发。建议流程是:
- 先在一台机器上把功耗墙、降压、稳定性都调好
- 记录下这套参数对应的算力与温度
- 在第二台同型号机器上应用同一套参数,观察是否有差异
- 确认两台都稳定后,再考虑批量下发
同型号显卡之间的体质差异很常见,一套参数在一台机器上稳定,在另一台上可能就掉驱动。批量下发之前先验证。
把调参放进收益核算里
调参的目的不是把算力榨到最高,而是让每瓦产出最大化。所以调完之后一定要把新参数代进收益核算里,重新算一遍回本周期。
具体怎么把电费、难度、币价和矿池费率放进同一套模型,可以参考 PRL 挖矿收益怎么算。
总结
PRL 的超频要点就三句话:功耗墙优先压、降压优于拉核心、显存频率别动。加上"一次只改一个变量、用实际到账验证"这两条纪律,基本不会走弯路。
最后提醒一句,这些参数建议都建立在"你已经有一台能稳定跑 24 小时的机器"这个前提上。如果机器本身还在报错、还在掉 worker,先解决问题再谈优化——不然你只是在给一个坏掉的基础设施做微调。
延伸阅读
- RTX 40 系列显卡挖矿性能实测:4070/4070Ti/4080/4090 哪款最划算?
- Gminer 2.95挖矿内核下载-90%解锁RTX 3050 和 RTX 3080 12GB
- Gminer 2.94挖矿内核下载-进一步解锁RTX 3050 和 RTX 3080 12GB
- RTX 4090 挖矿值得买吗?40 系列显卡回本周期实测分析
- 一代卡皇RTX4090的挖矿算力值